IA generativa · 2026-10-07 · 6 min
RAG y modelos en local: cuándo merece la pena no depender de una API
Qué he aprendido montando RAG con Qdrant, pgvector y LangGraph y sirviendo modelos de lenguaje en mi propio servidor. Cuándo compensa el modelo local y cuándo no.
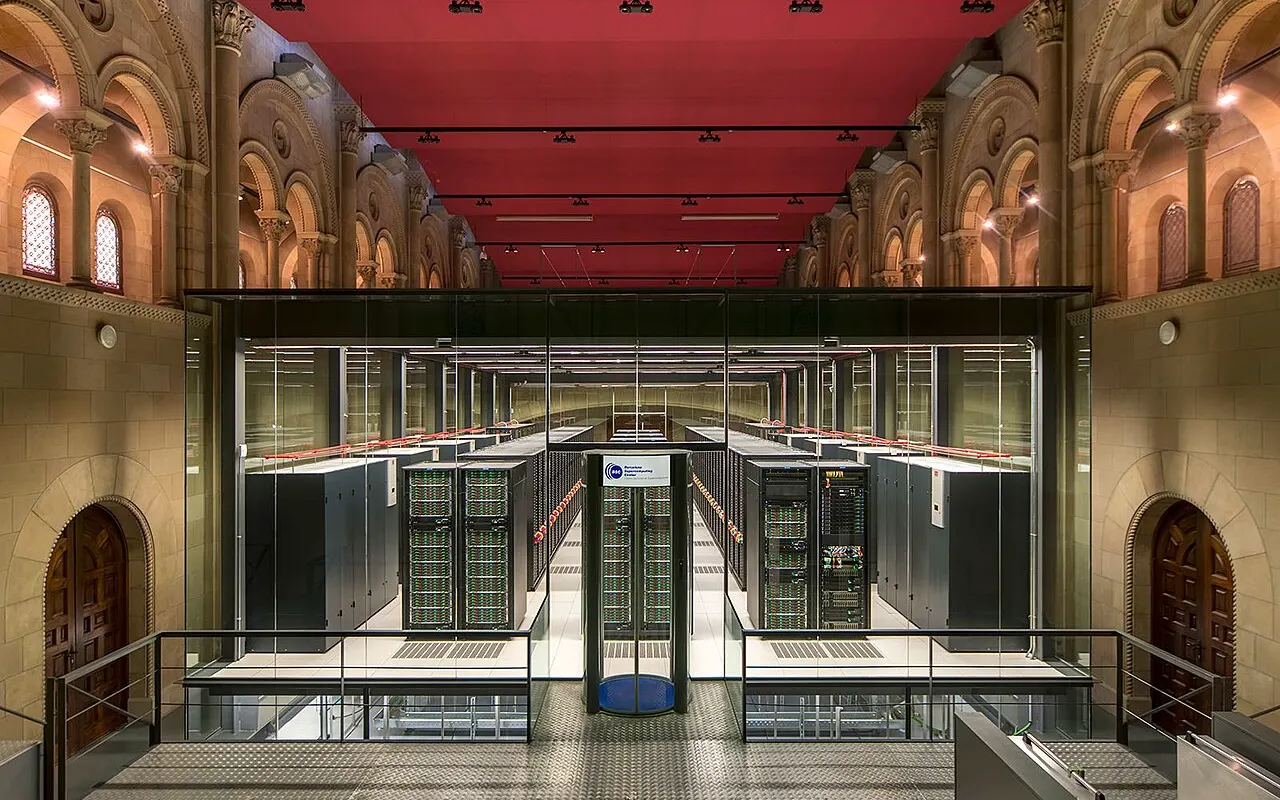
Casi todos los proyectos de IA generativa empiezan llamando a una API. Algunos no pueden: los datos son de clientes, de pacientes o de contabilidad, y no deben salir de la empresa. Para esos casos llevo tiempo montando la alternativa.
RAG: que el modelo conteste con tus documentos
La idea es sencilla: buscar los fragmentos relevantes y dárselos al modelo junto con la pregunta. La dificultad está en la ingesta. Un PDF troceado sin respetar sus secciones produce respuestas que suenan bien y están mal. Por eso mis canales de ingesta son conscientes de la estructura del documento.
No pagar dos veces el mismo trabajo
Reindexar una colección entera cada vez que cambia un fichero es caro y lento. Detectar duplicados por su huella y guardar un manifiesto de lo ya ingerido convierte la reindexación en algo que se puede lanzar a diario.
Agentes, con medida
He usado LangGraph para orquestar y CrewAI para repartir papeles entre agentes. Sirven cuando la tarea tiene pasos que dependen del resultado anterior. Para lo demás, un flujo fijo es más barato, más rápido y más fácil de depurar.
Servir el modelo en casa
En mi servidor corre una pasarela propia delante del motor de inferencia, con llamada a herramientas, caché de prompts, selección de modelo y métricas. Y he probado hasta dónde llega un modelo pequeño cuantizado sin GPU grande: más lejos de lo que parece para clasificar, extraer y resumir.
Cuándo compensa lo local
- Cuando los datos no pueden salir de la empresa.
- Cuando el volumen es alto y la tarea es repetitiva y acotada.
- Cuando necesitas que el coste sea fijo y previsible.
Cuándo no
- Cuando la tarea exige razonamiento largo o mucho contexto.
- Cuando nadie va a mantener el servidor.
- Cuando el uso es tan bajo que la API sale más barata que la electricidad.